A/B Testing | تست A/B
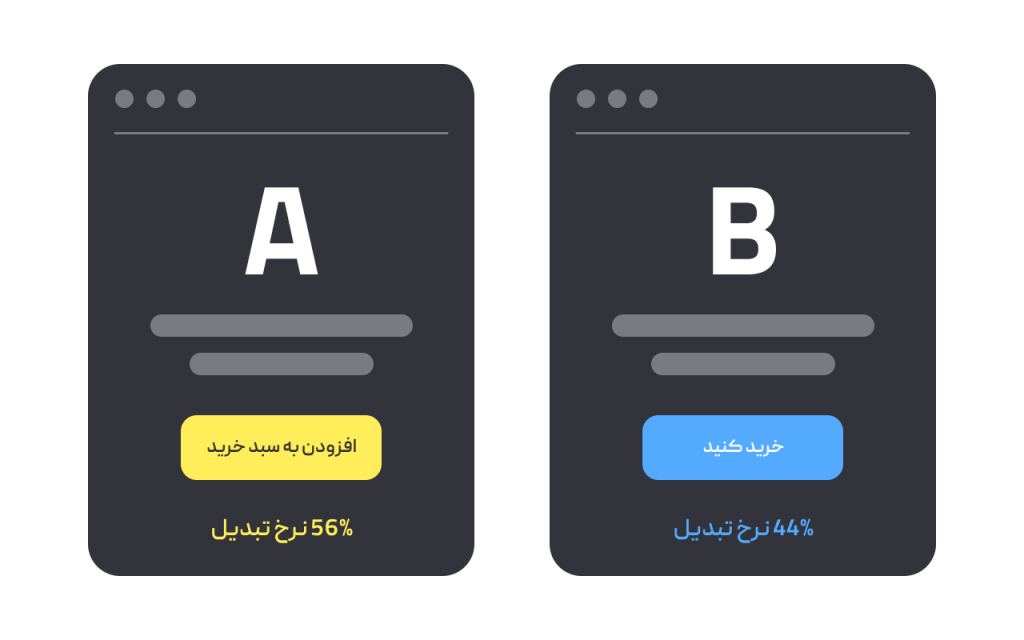
از سلیقه به تصمیم؛ نقش تست A/B در محصول
تست A/B در عمل ابزاری برای تصمیمگیری محصول است نه فقط یک قابلیت تحلیلی. وقتی تیم روی تیتر صفحهٔ فرود، ترتیب آنبوردینگ یا شکل فراخوان به اختلاف میرسد، آزمایش درست میتواند بحث را از سلیقه به شواهد رفتاری منتقل کند. دو تجربه بهصورت تصادفی به کاربران نشان داده میشود و اثر روی هدف مشخص مقایسه میشود. خروجی یک عدد است، اما کار واقعی تیم تفسیر آن عدد در زمینهٔ استراتژی، هزینه و تجربهٔ بلندمدت است.
نسخهٔ کنترل معمولاً واقعیت فعلی محصول است و نسخهٔ بدیل همان ایدهای است که میخواهید بیازمایید. تخصیص تصادفی کمک میکند تفاوتهای پنهان جمعیت تا حد ممکن متعادل شود. با این حال، حتی نتیجهٔ تمیز آماری هم بهتنهایی نمیگوید «حتماً منتشر کن»؛ فقط میگوید روی متریک اندازهگیریشده، یکی بهتر بوده است.
چه زمانی آزمایش تصمیم را بهتر میکند
آزمایش وقتی میدرخشد که مسئله روشن باشد، ترافیک کافی وجود داشته باشد، و هزینهٔ اشتباه انتشار بالا باشد. تغییر متن دکمه در صفحهٔ پرترافیک کاندیدای خوبی است. بازطراحی کامل اطلاعات معماری یا تغییر هویت برند معمولاً با چند A/B خرد بهتنهایی حل نمیشود و نیاز به کشف کیفی، نمونهسازی و ارزیابی جامعتر دارد.
اگر هنوز نمیدانید کاربر کجا گیج میشود، اول باید مسئله را بفهمید. تست کاربردپذیری، مصاحبه و تحلیل قیف قبل از ساختن دو نسخهٔ گران، جهت را تنگ میکنند. A/B برای مقایسهٔ راهحلهای رقیب عالی است، نه برای کشف صورتمسئله. تیمهایی که هر اختلاف نظری را فوراً به آزمایش میفرستند، بکلاگ را با آزمایشهای کمارزش پر میکنند و سرعت یادگیری واقعی را پایین میآورند.
انتخاب متریک؛ از کلیک تا پیامد
متریک آزمایش باید به هدف کسبوکار یا لحظهٔ ارزش نزدیک باشد. کلیک روی دکمه اگر به فعالسازی یا خرید وصل نباشد، میتواند بهینهسازی گمراهکننده بسازد. برای جریان ثبتنام، تکمیل پروفایل یا رسیدن به نخستین اقدام کلیدی معمولاً بهتر از صرف CTR است. متریکهای نگهبان مثل نرخ ریزش، زمان بارگذاری ادراکشده، یا تیکت پشتیبانی را هم از قبل مشخص کنید تا برندهٔ کوتاهمدت به تجربهٔ بلندمدت لطمه نزند.
در محصولات فصلی یا کمپینمحور مراقب بازههای غیرعادی باشید. آزمایش فقط در ایام تخفیف ممکن است نتیجهای بدهد که در روز عادی تکرار نشود. نماینده بودن ترافیک بخشی از کیفیت تصمیم است، نه جزئیات آماری لوکس.
همنشینی با تحقیق کیفی
وقتی نسخهٔ B میبازد، عدد بهتنهایی علت را نمیگوید. همانجا مصاحبه، بازبینی جلسه، یا نظرسنجی هدفمند کمک میکند بفهمید پیام نامفهوم بوده، اعتماد کم شده، یا اصطکاک تازهای اضافه شده است. وقتی چند جهت طراحی روی میز است، پژوهش کیفی میتواند گزینهها را قبل از هزینهٔ مهندسی غربال کند و فقط دو نامزد جدی وارد آزمایش شوند.
تحلیل رفتار مداوم هم خوراک فرضیه میسازد: صفحات با پرش بالا، مراحل رهاشده، یا قابلیتهای کماستفاده. فرهنگ آزمایشِ پیوسته یعنی این سیگنالها وارد صف فرضیه میشوند، اولویت میگیرند و بعد از اجرا یادگیریشان مستند میشود. بدون این حلقه، A/B مجموعهای از پروژههای پراکنده است.
تصمیم انتشار؛ فراتر از برنده شدن داشبورد
نتیجهٔ معنادار میگوید نسخهٔ B روی متریک اصلی بهتر بوده است. هنوز باید بپرسید: هزینهٔ نگهداری چقدر است؟ آیا با معماری طراحی سیستم میخواند؟ آیا اثر منفی پنهان روی سگمنت کمحجم اما حیاتی هست؟ آیا دسترسیپذیری یا عملکرد آسیب دیده؟ تیمهایی که هر برندهٔ آماری را خودکار منتشر میکنند، ممکن است محصول را حول یک متریک باریک خم کنند و انسجام تجربه را از دست بدهند.
برعکس، نادیده گرفتن مکرر شواهد بدون دلیل مکتوب هم فرهنگ داده را تضعیف میکند. مسیر سالم این است که نتیجه بهعنوان یکی از ورودیهای تصمیم در کنار ریسک فنی، استراتژی و بینش کیفی ثبت شود. سند تصمیم کوتاه بعد از هر آزمایش، یادگیری را سازمانی میکند.
نقش طراح و مدیر محصول در آزمایش
طراح فرضیهٔ تعامل میسازد، نسخههایی طراحی میکند که فقط همان متغیر اصلی را جابهجا کنند، و یکپارچگی تجربه را حفظ میکند تا آزمایش به جنگ بصری تصادفی تبدیل نشود. مدیر محصول اولویت آزمایش را با تأثیر و هزینه میچیند، متریک موفقیت را Negotiates میکند و مطمئن میشود نتیجه به نقشهٔ راه وصل است. مهندسی صحت تخصیص، اندازهگیری و پرچم ویژگی را تضمین میکند. بدون این سه نقش، آزمایش یا غیردقیق است یا بیاثر در تصمیم.
در جلسهٔ بازبینی نتیجه، بهجای جشن یا دفاع شخصی، روی سازوکار فرضیه تمرکز کنید. اگر B برد، چه اصل طراحی تعمیمپذیر است؟ اگر نبرد، چه را یاد گرفتیم که آزمایش بعدی را باهوشتر میکند؟ این پرسشها A/B را از مسابقهٔ سلیقه به موتور یادگیری تبدیل میکنند.
محدودیتها؛ چه چیزی را نباید از A/B انتظار داشت
A/B اثر رفتاری مقیاسپذیر را خوب میسنجد، اما جایگزین ارزیابی دسترسیپذیری تخصصی نیست. بهبود میانگین کاربران نمیگوید تجربه برای کاربران فناوری کمکی بهتر شده است. همچنین اثرهای بلندمدت برند، اعتماد و بدهی تجربه ممکن است در پنجرهٔ کوتاه آزمایش دیده نشوند. برای تغییرات عمیق راهبری اطلاعات یا مدل ذهنی، روشهای مکمل لازم است.
تداخل چند آزمایش روی یک صفحه هم تصمیم را آلوده میکند. اگر دو آزمایش همپوشان همزمان اجرا شوند، تفسیر برنده سخت میشود. اولویتبندی صف آزمایش و جداسازی سطوح تغییر بخشی از حکمرانی آزمایش است.
الگوی عملی برای تیمهای متوسط
یک صف فرضیه نگه دارید، هر فرضیه یک سازوکار و یک متریک داشته باشد، فقط آزمایشهایی را وارد اجرا کنید که ترافیک و اهمیت کافی دارند، و بعد از پایان یک پاراگراف تصمیم بنویسید: منتشر شد، رد شد، یا نیاز به پژوهش بیشتر دارد. این الگوی سبک برای تیمهایی که مثل غولهای فناوری هزار آزمایش موازی ندارند واقعبینانه است و همچنان تصمیمها را Evidential میکند.
از زاویهٔ تصمیم محصول و UX، تست A/B یعنی آوردن رفتار واقعی کاربر به میز اولویتبندی؛ با آگاهی از محدودیتها، احترام به پژوهش کیفی، و امتناع از تبدیل خودکار عدد به انتشار. وقتی این تعادل برقرار باشد، آزمایش سرعت یادگیری را بالا میبرد بدون اینکه محصول را به مجموعهای از بهینههای محلی بیارتباط تبدیل کند.
نمونهٔ مسیر تصمیم در یک اسپرینت
فرض کنید تیم بین دو نسخهٔ آنبوردینگ اختلاف دارد: یکی کوتاه با سه گام، دیگری بلندتر با آموزش بیشتر. بهجای رأیگیری سلیقهای، فرضیه نوشته میشود که نسخهٔ کوتاه نرخ تکمیل را بالا میبرد اما ممکن است فعالسازی روز سوم را ضعیف کند. متریک اصلی تکمیل آنبوردینگ و متریک نگهبان رسیدن به اقدام کلیدی در سه روز تعیین میشود. پس از رسیدن به حجم نمونه، اگر تکمیل بهتر شده ولی فعالسازی افت کرده، تصمیم انتشار مشروط است: یا نسخه را اصلاح کنید یا فرض کنید کوتاهسازی بیش از حد ارزش را پنهان کرده است. این داستان نشان میدهد A/B پایان بحث نیست؛ ورودی برای قضاوت محصول است.
در سازمانهایی که هنوز فرهنگ آزمایش ندارند، از یک جریان کمریسک شروع کنید، نتیجه را عمومی مستند کنید، و فقط بعد از دیدن یادگیری واقعی دامنه را گسترش دهید. اعتماد به روش با بردهای شفاف ساخته میشود نه با اجبار داشبورد.
سوالات متداول
تقریباً بله؛ اصطلاح split testing بیشتر بر تقسیم ترافیک بین نسخهها تأکید دارد و در عمل مترادف رایج A/B Testing است.
متریکی نزدیک به هدف کسبوکار یا لحظهٔ ارزش؛ مثل تکمیل خرید یا فعالسازی، نه فقط کلیک مگر اینکه خودش پیامد میانی معنادار باشد.
ممکن است تداخل ایجاد شود. بهتر است آزمایشها اولویتبندی شوند یا بخشهای غیرهمپوشان داشته باشند و حکمرانی صف روشن باشد.
ساخت فرضیه و نسخههای معنادار، حفظ یکپارچگی تجربه، و کمک به ترجمهٔ نتیجه به اصل طراحی قابل تعمیم؛ نه فقط تحویل دو فایل بصری.
وقتی به حجم و معیار ازپیشتعیینشده رسیدید، یا اگر متریک نگهبان آسیب جدی دید. توقف بهخاطر هیجان زودهنگام نتیجه معمولاً خطاست.